file_get_contents($path) 一行就能读完一个文件。它太快、太顺手,以至于几乎没人问过:这一行到底经过了几层,慢的时候又慢在哪一层。
答案比想象的直白:同一次读取,快慢能差出三个数量级。同样是读 64 MB,热缓存 5.8 GB/s,冷读 758 MB/s,直连设备 945 MB/s;同样是调 fread(),读 8 KB 一次和读 1 字节一次,差 320 倍。
这篇把一次 read 拆成四层,每层都给出实测数字。所有数据在 Ubuntu(内核 6.8,virtio 盘)上跑 PHP 8.3.36 得到,脚本和复现命令都放在文末。
一、一次 read 经过四层
$f = fopen('data.bin', 'rb');
$chunk = fread($f, 8192);
这四行里只有一次真正的读取动作,但它穿过了四个层次:
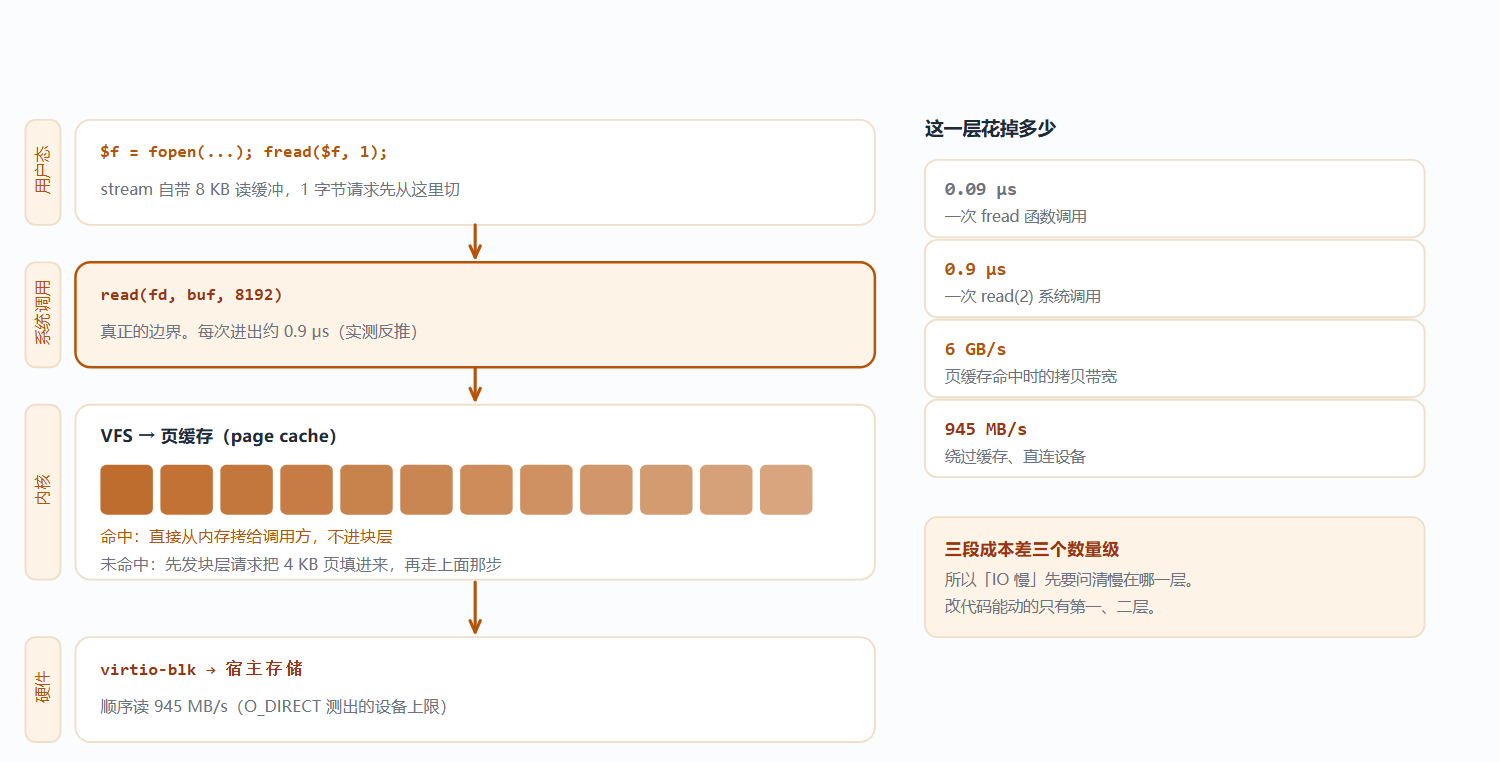
第一层,PHP 的用户态缓冲。 fread() 默认不是直接进内核,它先看 PHP stream 自己的 8 KB 读缓冲里有没有存货,有就直接切一块给你。这一层每次调用约 89 ns,纯内存操作。
第二层,系统调用。 缓冲空了才真正进内核,一次 read(2) 约 0.9 μs —— 比上一层的函数调用贵十倍,因为要切换特权级、切换栈、还要把参数搬过去。
第三层,VFS 和页缓存。 内核先查这个文件对应的页在不在内存里。在,直接从页缓存拷到你的缓冲区,带宽约 6 GB/s;不在,才往下走。
第四层,块层和设备。 发真正 IO 请求给 virtio 块设备,实测顺序读上限 945 MB/s。
这四层的成本差了三个数量级。所以「IO 慢」首先要问:慢在函数调用、慢在系统调用、慢在缓存没命中,还是慢在磁盘。改代码能动的只有第一、二层,后两层只能靠减少次数绕开。
二、页缓存:第二次读为什么不要钱
先用 dd 量一下同一个 64 MB 文件在不同状态下的读速度。为了做出真正的冷读,不要用 echo 3 > /proc/sys/vm/drop_caches(那会把整台机器的缓存都清掉,线上这么干是事故),只丢弃这一个文件的页:
sync
python3 -c "
import os
fd = os.open('bench.bin', os.O_RDONLY)
os.posix_fadvise(fd, 0, 0, os.POSIX_FADV_DONTNEED)
os.close(fd)
"
POSIX_FADV_DONTNEED 只对该文件的 clean page 生效,范围可控,是测 IO 时更该用的手段。清完读四次:
dd if=bench.bin of=/dev/null bs=1M # 冷读
dd if=bench.bin of=/dev/null bs=1M # 热读
dd if=bench.bin of=/dev/null bs=1M # 热读
dd if=bench.bin of=/dev/null bs=1M iflag=direct # 绕过页缓存| 条件 | 速度 | 说明 |
|---|---|---|
| 冷读(页缓存已丢弃) | 758 MB/s | 从设备读,还要填缓存 |
| 热读第 2 次 | 4.3 GB/s | 全命中内存 |
| 热读第 3 次 | 5.8 GB/s | 全命中内存 |
O_DIRECT(绕过缓存) | 945 MB/s | 设备真实上限 |
热读但 bs=4K | 2.1 GB/s | 命中缓存,但系统调用多了 256 倍 |
三件事值得单独说。
热读比冷读快 7.6 倍,这部分是白送的。 第二次读同一个文件,数据已经在页缓存里,read(2) 只是把内存拷一份,根本不碰磁盘。所以「接口第一次慢、之后快」不是代码优化生效了,是缓存生效了。
冷读(758 MB/s)比 O_DIRECT(945 MB/s)还慢,这有点反直觉。 冷读时数据要先从设备进页缓存(一次 DMA),再从页缓存拷到 dd 的缓冲区(一次 CPU 拷贝),两份成本叠加;O_DIRECT 跳过页缓存直接进用户缓冲,少一道。代价是后续再读还是冷的。
4 KB 块的 2.1 GB/s 说明缓存也救不了系统调用。 同样全命中,1 MB 块 5.8 GB/s,4 KB 块 2.1 GB/s —— 因为块小了 256 倍,read(2) 的次数就多了 256 倍。内存拷贝本身很快,是进出内核的次数把速度拖下来了。
写路径同理,方向相反:fwrite() 返回时数据通常只写进了页缓存,标记为 dirty,等着内核的回写线程(vm.dirty_expire_centisecs,默认 30 秒)刷到磁盘。fwrite() 返回 true 不代表落盘,断电就没了。这一点在第六节展开。
三、PHP 的 8 KB 缓冲:fread($f, 1) 没那么蠢,但也没那么快
一个常见的写法是按字节读:
while (!feof($f)) {
    $ch = fread($f, 1);
    // ...
}
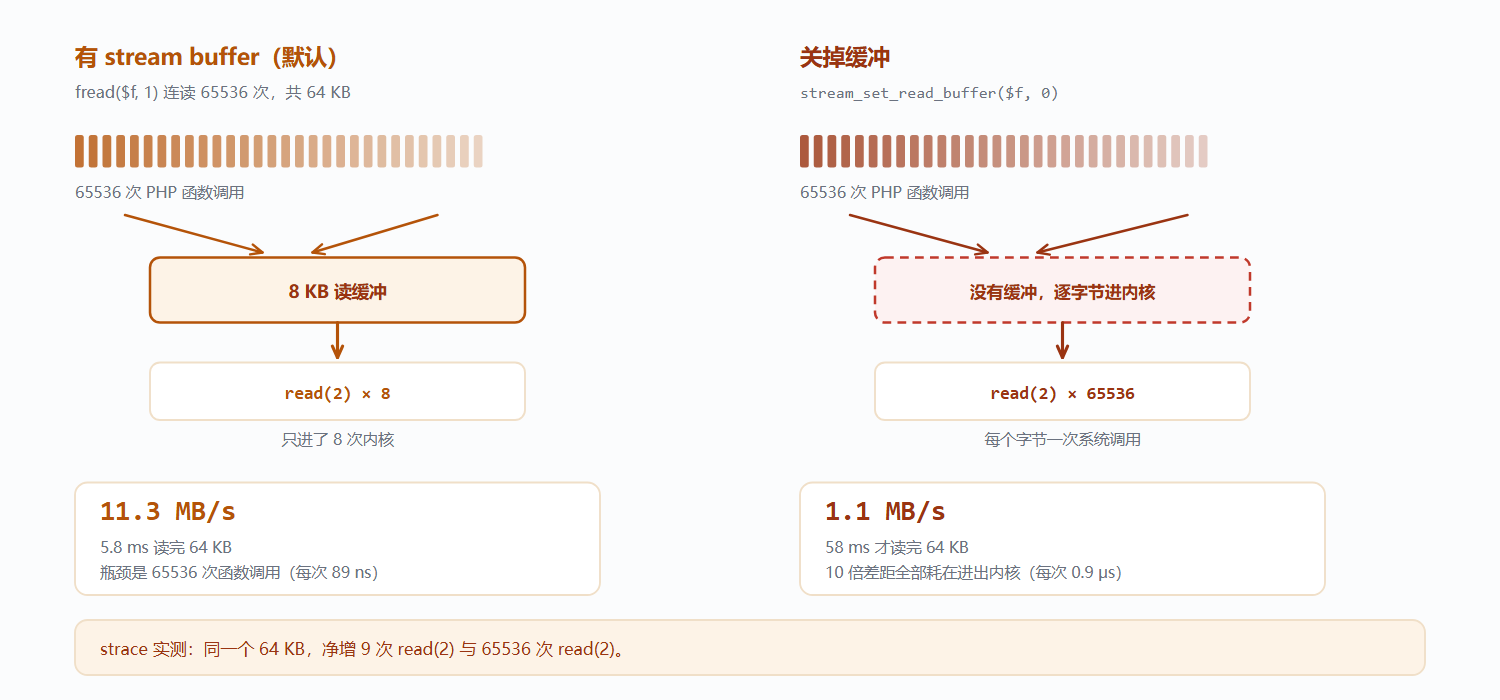
看着像灾难。实测一下到底有几次系统调用:
strace -f -e trace=read -o sc.log php syscall_probe.php bench.bin 65536 1 1
grep -c 'read(' sc.log
syscall_probe.php 就是按指定块大小读指定字节数,最后两个参数是「总计读 65536 字节」和「每次读 1 字节」。结果:
有 buffer:108 次 read
无 buffer:65635 次 read
108 次里有 99 次是 PHP 启动时加载扩展产生的基线,净增只有 9 次 —— 8 次取数据,1 次收尾判 EOF。65536 字节全被 8 KB 的流缓冲吃掉了。而加上 stream_set_read_buffer($f, 0) 关掉缓冲,就是老老实实 65635 次。
但「没那么蠢」不等于「够快」。把块大小从 1 字节扫到 1 MB,读 64 MB 文件(1 字节到 1 KB 这几档只读前 2 MB,否则太慢,所以看吞吐 MB/s 而不是总耗时):
fread 大小 | 有流缓冲 | 无流缓冲 |
|---|---|---|
| 1 B | 11.3 MB/s | 1.1 MB/s |
| 64 B | 626.8 MB/s | 67.8 MB/s |
| 512 B | 2540.6 MB/s | 532.2 MB/s |
| 1 KB | 3614.5 MB/s | 1055.5 MB/s |
| 4 KB | 3464.7 MB/s | 2725.5 MB/s |
| 8 KB | 3635.5 MB/s | 3912.5 MB/s |
| 64 KB | 3818.0 MB/s | 6327.6 MB/s |
| 1024 KB | 3509.7 MB/s | 5875.3 MB/s |
三个结论,一个比一个反直觉。
小块读时,缓冲是救命的。 1 字节从 1.1 MB/s 提到 11.3 MB/s,正好十倍,因为系统调用少了 8192 倍。这一层的价值在这里。
但 1 字节还是比 8 KB 慢 320 倍。 这时候瓶颈已经不在内核了:读 2 MB 要调 200 万次 fread(),每次 89 ns,光函数调用就 178 ms。系统调用被缓冲兜住了,PHP 函数调用的成本兜不住。
超过 8 KB,关掉缓冲反而更快。 64 KB 时 3818 → 6327 MB/s,快了 65%。原因是 PHP 的 stream 有个 chunk_size(默认 8192),带着缓冲时单次底层 read(2) 最多只取 8 KB,fread($f, 65536) 得循环读 8 次再拼接。这不是猜的 —— 手写 fread($f, 65536) 循环读 64 MB,strace 记到 8292 次 read,64 MB ÷ 8192 = 8192,正好对上。关掉缓冲后一次 read(2) 就能取满 64 KB,少了两层拼接。
所以实际该选多大:8 KB 到 64 KB 之间,跟 stream_set_chunk_size() 对齐,别按字节读,也别迷信越大越好。
四、五种读法:file() 的 215 MB
同样是读一个 81 MB、100 万行的日志文件,五种常见写法:
| 读法 | 耗时 | 峰值内存 |
|---|---|---|
fgets() 逐行 | 85.7 ms | 2.0 MB |
fread() 64 KB 整块 | 27.3 ms | 2.0 MB |
SplFileObject 逐行 | 111.5 ms | 2.0 MB |
file() | 143.8 ms | 215.0 MB |
file_get_contents() + explode() | 202.4 ms | 309.9 MB |
fread() 整块最快,这个在意料之中。真正要看的是内存那一列:81 MB 的文本读成数组要 215 MB,膨胀 2.65 倍。
原因在上一篇讲数组时说过:每一行是一个 zend_string(字符串头 24 字节 + 内容 + 对齐),再加一个 Bucket(32 字节),还要维护哈希表。一行 84 字节的文本,落到内存里接近 210 字节。
后果很直接。默认 memory_limit = 128M 的机器上:
PHP Fatal error:  Allowed memory size of 134217728 bytes exhausted
(tried to allocate 2097152 bytes)
一个 81 MB 的日志文件,用 file() 读直接把进程打死。 这个报错信息还特别有迷惑性:它说「尝试分配 2 MB 失败」,看起来像只要 2 MB,实际是前面已经把 128 MB 吃光了。
所以选型很清楚:
- 要逐行处理 →
fgets()或SplFileObject,内存恒定,2 MB - 要整块处理(正则、替换、统计) →
fread()分块循环,别图省事用file() file()只适合几百 KB 的小配置文件,超过 10 MB 就该换写法
顺带一句:file_get_contents() 本身不算慢,慢在后面的 explode() 造了 100 万个数组元素。如果只是 substr_count($s, "\n") 数行数,那内存里只有一个 81 MB 的字符串,不会再翻三倍。
五、readfile() 不是流式发送
readfile() 是发文件下载最常用的函数,直觉上它应该是「读一块、发一块」。用 strace 看一眼就露馅了:
strace -f -yy -e trace=mmap,write,read -s 0 -o m.log \
    php -r 'readfile("bench.bin");' > /dev/null
mmap(NULL, 67108864, PROT_READ, MAP_SHARED, 3, 0) = 0x7f...
write(1, "...", 67108864) = 67108864一次 mmap 把整个文件映射进地址空间,一次 write 把 64 MB 全送出去,read 一次都没有。
这也解释了另外两个观测:峰值内存只有 2 MB(映射不计入 PHP 堆,这也是为什么 200 MB 的文件在 memory_limit=128M 下也能发出去),以及写 /dev/null 只要 0.02 秒、写真实文件要 0.07 秒(/dev/null 的 write 直接丢弃,不碰那 64 MB)。
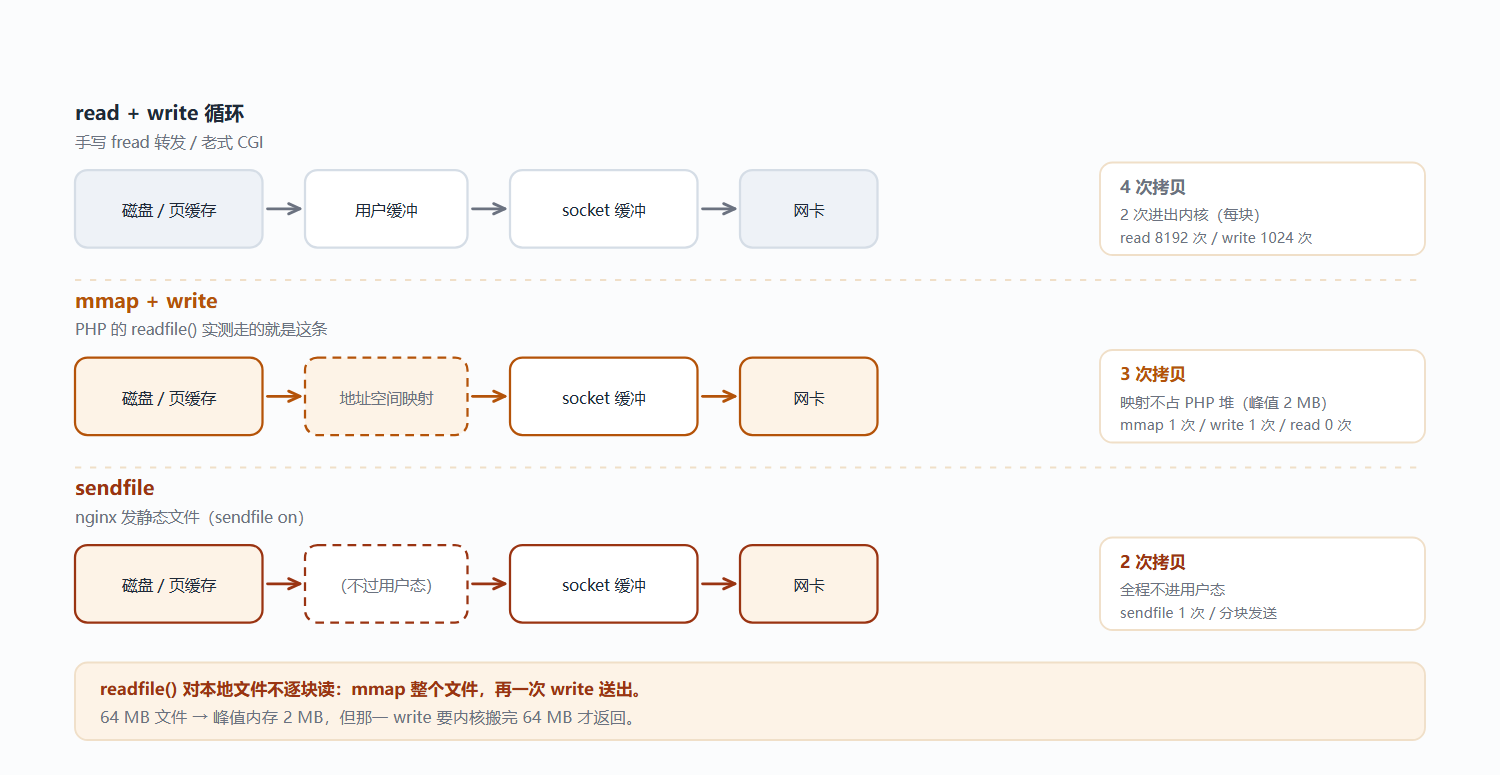
这个行为和 nginx 发静态文件不是一回事。nginx 开 sendfile on(本站配置里第 37 行就是)走的是 sendfile(2),数据从页缓存直接进网卡,全程不进用户态,而且是分块流式发送。
readfile() 的一次性 write 意味着什么?内核必须把 64 MB 全部从页缓存搬进 socket 发送缓冲才开始返回。客户端慢,这个 write 就跟着慢,而它占着的是一个完整的 PHP-FPM 进程。几个大文件下载同时发生,pm.max_children 就被吃光了 —— 表现是「整个站都卡」。
正确做法是让 web 服务器去发文件,PHP 只负责鉴权:
// 鉴权通过后,把发送工作交给 nginx
header('Content-Type: application/octet-stream');
header('X-Accel-Redirect: /protected/' . $filename);
exit;
location /protected/ {
internal;
alias /www/data/;
sendfile on;
tcp_nopush on;
}internal 保证这个路径只能被内部重定向访问,外部直接请求是 404。PHP 侧的内存占用降到几百 KB,发送由 nginx 用 sendfile 分块完成。
六、写:fwrite 返回了不代表安全
写 10 万行日志(每行约 80 字节,共 8 MB),六种写法:
| 写法 | 耗时 | 备注 |
|---|---|---|
逐行 fwrite()(默认缓冲) | 139.8 ms | 10 万次函数调用 |
逐行 fwrite()(关缓冲) | 137.0 ms | 几乎一样 |
| 每 1000 行拼一次 | 34.5 ms | 100 次 write(2) |
| 全部攒完一次写 | 49.9 ms | 一次性分配 8 MB |
每 1000 行 + fsync() | 242.6 ms | 100 次落盘 |
每行 fsync() | 30292.5 ms | 只跑了 2 万行 |
注意第二行。 关掉写缓冲几乎不影响速度(139.8 → 137.0 ms),这和读方向完全不同。原因在第三层:Linux 上 write(2) 写进页缓存本来就极快,成本主要在 PHP 自己的函数调用和内存拷贝上。所以「逐行写慢」的锅不该让系统调用背 —— 它慢在 10 万次 fwrite() 调用,以及每次调用都要检查缓冲、算长度。
攒批写是这个表的答案:把 100 次写摊到 8 MB 上,34.5 ms,比逐行快 4 倍。但别一次攒太多 —— 「全部攒完一次写」反而慢到 49.9 ms,因为要一次性分配 8 MB 并做字符串追加($buf .= $line 在 PHP 里是复制,O(n²) 的隐患就在这里)。
真正的分水岭在 fsync() 那一行。 每 1000 行落一次盘,10 次/秒的量级还能接受(242.6 ms 里绝大部分是 100 次 fsync);每行都 fsync,2 万行要 30 秒 —— 单次 1.5 ~ 2.4 ms,这就是等磁盘确认的代价。
所以日志的写法是有取舍的:
- 普通业务日志 → 攒批写,不加
fsync。断电可能丢最后几秒,能接受 - 审计、账务 → 每批
fsync,或者干脆进数据库用事务 - 绝对不想自己管 → 交给 syslog / 日志服务
还有一个容易被忽略的点:别在循环里 fopen / fclose。每次 fclose() 都要刷缓冲,效果和 fsync 差不多,但没人会意识到自己在做这件事。
七、小结
- 一次
read有四层成本:函数调用 89 ns、系统调用 0.9 μs、页缓存拷贝 6 GB/s、设备 945 MB/s,差三个数量级 - 热读快 7.6 倍是缓存白送的,测性能必须先区分冷读和热读;只丢单个文件的缓存用
posix_fadvise(DONTNEED),别动drop_caches fread($f, 1)有 8 KB 流缓冲兜着,内核只被进 8 次而不是 65536 次;但 200 万次函数调用照样把它拖到 11.3 MB/s- 块大小选 8 KB ~ 64 KB;超过 64 KB 时
stream_set_read_buffer($f, 0)反而更快 file()读 81 MB 文本要 215 MB 内存,默认memory_limit下直接 Fatal;逐行处理用fgets()或SplFileObjectreadfile()不是流式发送,它mmap整个文件再一次write;大文件下载交给 nginx 的X-Accel-Redirect+sendfilefwrite()返回true只代表写进了页缓存;fsync()单次约 1.5 ms,每行 fsync 写 2 万行要 30 秒,攒批写 10 万行只要 34 ms
排查 IO 问题时按这个顺序问:
- 慢在哪一层 —— 单次操作 100 ns 级是函数调用,1 μs 级是系统调用,10 μs 以上进内核了
- 冷读还是热读 —— 同一个接口第一次和第二次差 7 倍,先排除缓存
- 块大小是多少 —— 小于 8 KB 就该改,大于 64 KB 检查缓冲开关
- 是不是自己在手写大批量小 IO —— 逐行读、逐行写、循环里 fopen,都能靠攒批解决
实测环境:Ubuntu / 内核 6.8.0 / 3.7 GB 内存 / virtio 块设备 / PHP 8.3.36 (cli)。测试文件 64 MB 随机数据与 81 MB 文本(100 万行),全部在 /tmp 下生成,测完删除。脚本在仓库 tools/io_bench/,run.sh 一条命令跑完全部。