PHP 的数组大概是所有语言里最好用的数据结构:能当列表、能当字典、能当集合、能当队列,还保留插入顺序。但它底下到底长什么样?为什么 $a = $b 几乎不花时间?为什么 unset 一堆元素之后内存没降?
这篇从 zval 讲到 packed array,再讲写时复制,所有数字都是 PHP 8.3.13 上实测的。
一、它不是数组,是一张有序哈希表
C 里的数组是一段连续内存,a[5] 就是「首地址 + 5 × 元素大小」。PHP 的数组不是。
PHP 的数组底层叫 HashTable,同时维护两份信息:
- 一张哈希索引:键 → 元素位置,用于
$a['key']的 O(1) 查找 - 一条顺序链:记录插入顺序,用于
foreach按插入顺序遍历
这就是「PHP 数组是有序字典」的由来。['b' => 1, 'a' => 2] 遍历出来还是 b、a,不像 Java 的 HashMap 会乱序。
代价是:每个元素都要额外存哈希值和链接指针,内存开销比 C 数组大得多。
二、zval:每个值 16 字节
PHP 里所有变量值都是一个 zval 结构。PHP 7 重构后,它长这样:
struct _zval_struct {
    zend_value      value;      // 8 字节,联合体,存 long/double/指针
    union {
        uint32_t    type_info;  // 类型标记 + 若干标志位
        ...
    };
};                              // 合计 16 字节
关键点是 16 字节。PHP 5 时代这个结构是 24 字节(值 16 + 引用计数 4 + 是否引用 1 + 类型 1 + 对齐),PHP 7 把引用计数挪到了具体的值结构里,zval 直接瘦身三分之一。
所以「PHP 7 比 PHP 5 快一倍」不是玄学,光内存带宽就省了一大截。
除了 zval,还有一层:
typedef struct _Bucket {
    zval              val;   // 16 字节
    zend_ulong        h;     // 8 字节,哈希值
    zend_string      *key;   // 8 字节,字符串键的指针
} Bucket;                    // 合计 32 字节
一个哈希表的元素,实际成本是 32 字节的 Bucket,加上字符串键自己的 zend_string。
三、packed array:PHP 7 最大的隐藏优化
如果数组的键恰好是 0, 1, 2, 3 ... 连续递增的整数,PHP 7 起会自动切到一种特殊布局:packed array。
这种布局下不再需要 Bucket,元素就是一个紧挨着的 zval 数组:
hash 形态:  [Bucket 32B][Bucket 32B][Bucket 32B] ...
packed 形态:[zval 16B][zval 16B][zval 16B] ...查找也退化成纯算术:$a[5] → 首地址 + 5 × 16,连哈希都不用算。
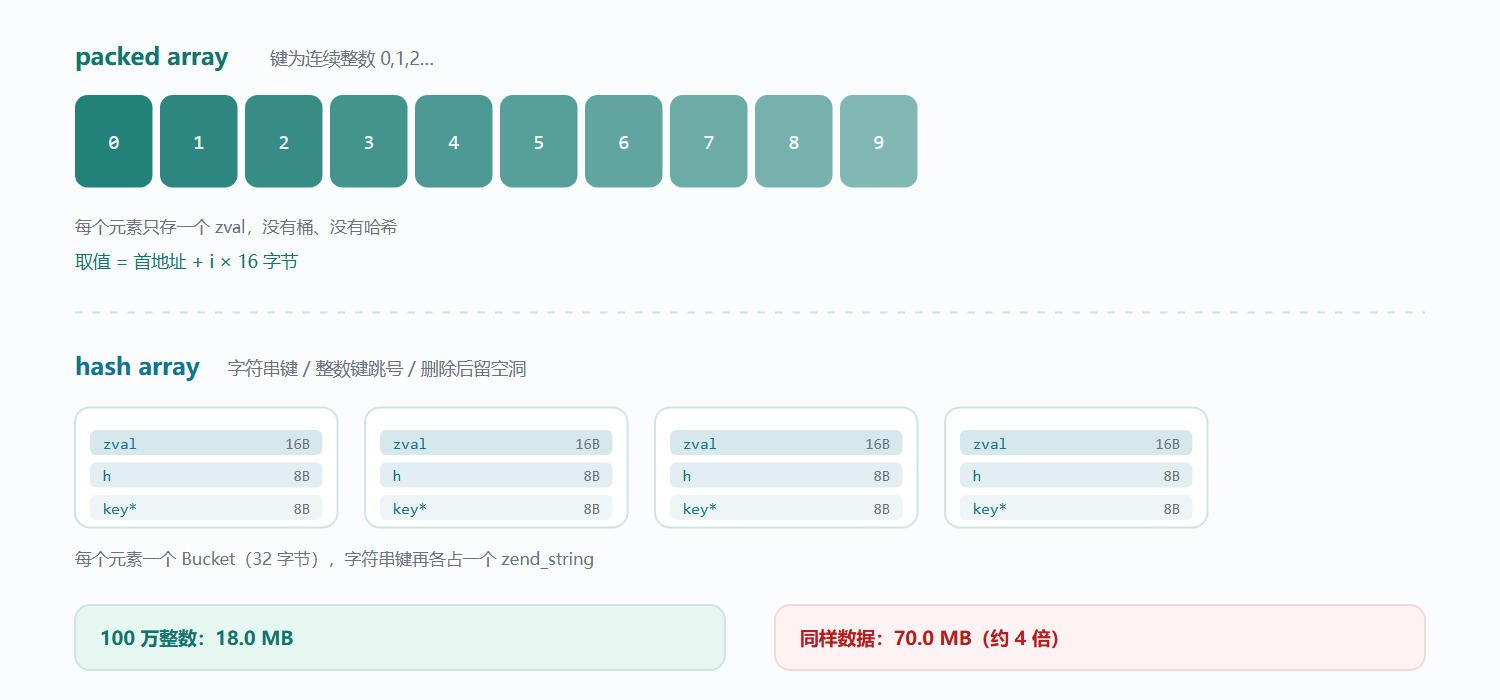
三种写法的实测内存(100 万个整数,memory_get_usage(true)):
| 写法 | 内存 | 每元素 |
|---|---|---|
range() 生成的连续整数(packed) | 18.0 MB | 约 18 字节 |
| 循环写字符串键(hash) | 70.0 MB | 约 70 字节 |
SplFixedArray(定长) | 16.0 MB | 16 字节 |
对应的三份代码,可以直接复现:
$N = 1000000;

$a = range(1, $N);                    // packed:18.0 MB
$h = [];
for ($i = 0; $i < $N; $i++) {         // hash:70.0 MB
    $h["k$i"] = $i;
}
$s = new SplFixedArray($N);           // 定长:16.0 MB
for ($i = 0; $i < $N; $i++) {
    $s[$i] = $i;
}同样的数据量,用了字符串键就多花将近 4 倍内存。原因是每个元素都要一个 Bucket,每个键还要一个独立的 zend_string(24 字节头 + 内容 + 对齐)。
触发 hash 形态的情况有四种,很多人只注意到第一种:
- 用了字符串键
- 整数键但不连续,比如
$a[1] = 1; $a[3] = 2;(跳过了 2) - 键是负数
- 删除元素后出现空洞 —— 这是最容易忽略的,
unset($a[0])之后如果后面又追加,可能就地退化成 hash
不管哪种,性能都还是 O(1),只是内存翻几倍。数据量上百万时才值得在意。
四、写时复制:$b = $a 为什么是免费的
这是 PHP 数组最反直觉的一点:
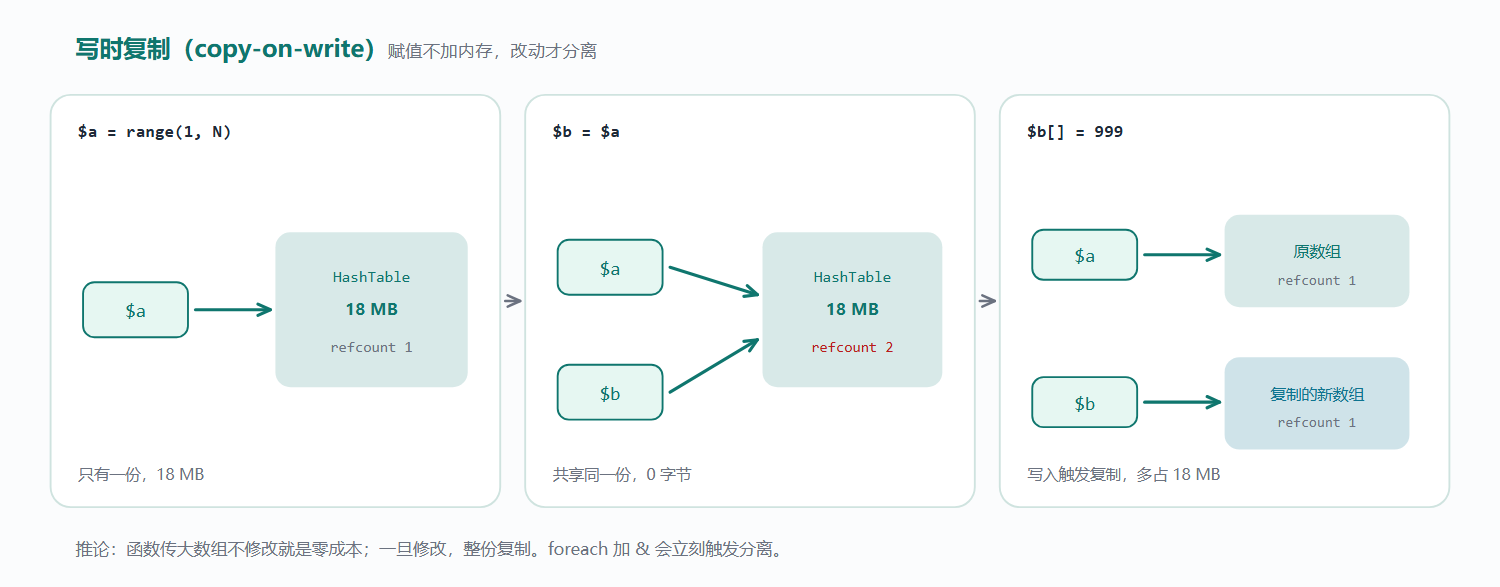
$a = range(1, 1000000);   // 18.0 MB
$b = $a;                  // 0.0 MB  ← 真的没分配
$b[] = 999;               // 18.0 MB  ← 这时才复制
实测就是这样:赋值那一刻内存增量是 0,直到 $b 被修改才真正复制一份。
机制是每个数组有个 refcount(引用计数)。$b = $a 只是把计数 +1,两个变量指向同一块 HashTable。真正要写的时候检查 refcount > 1,才复制一份出来 —— 这就是 copy-on-write。
把这个逻辑串起来测:
$a = range(1, 1000000);   // +18.0 MB
$b = $a;                  // +0.0 MB
$c = $b; $c[0] = 5; // +36.0 MB (复制了一份给 $c)(memory_get_usage(true) 有 2 MB 的页粒度,所以数字都是整段跳变的。)
实用推论有三条:
函数传参不会复制数组。 只要函数内部不修改,传一个 10 万元素的数组进去是零成本的。
但一旦修改就会复制。 所以「把大数组传进函数里改一个元素」很贵,要传引用 &$arr 或者改返回值。
foreach 值遍历不复制。 实测 50 万元素,遍历前后内存增量 0:
foreach ($a as $v) { $sum += $v; } // +0.0 MB因为 $v 是 zval 的副本(标量本来就是值拷贝),原数组的 refcount 没变。
但只要写了引用符号,立刻分离:
foreach ($a as &$v) { $v = $v * 2; }  // 强制复制整个数组 + 留下悬空引用
unset($v);                            // 必须手动 unset,否则二次遍历会踩坑
foreach (&$v) 后忘了 unset($v) 是个经典 bug:下一轮同名 foreach 会复用同一个引用槽,最后一个元素被反复覆盖。
五、unset 不缩容
这条坑过很多人。填满 20 万个元素的数组,逐个 unset 全部元素:
装满 8.0 MB → 全部 unset 后 8.0 MB一个字节都没还给系统。 因为 HashTable 内部的 bucket 缓冲区只会扩容,不会自动收缩;unset 只是把那个位置的 zval 标成 IS_UNDEF,桶本身还占着。
真正回收要满足两个条件之一:
unset($a);            // 整个变量销毁,refcount 归零 → 释放
$a = []; // 换一个新的空数组,旧的整体释放所以批处理场景的正确写法是分段 + 整体丢弃,不是「清空这个数组继续用」:
// 错:内存只涨不降
foreach ($rows as $row) {
    $buffer[] = transform($row);
    if (count($buffer) > 10000) {
        flushToDb($buffer);
        $buffer = [];      // 必须重新赋值,不能靠 array_splice
    }
}
array_splice($buffer, 0, 10000) 看着像清空,实际上要搬移剩下的元素并重建索引,而且老的桶区不会缩。
六、几条能立刻用上的建议
循环里不要 array_merge。 每次 merge 都会新建一个数组并复制两边全部元素,循环 N 次就是 O(n²):
// 慢:每次都复制一遍已有结果
$all = [];
foreach ($chunks as $c) { $all = array_merge($all, $c); }

// 快:一次合并
$all = array_merge(...$chunks);

// 或者直接往同一个数组里塞,走追加路径
$all = [];
foreach ($chunks as $c) { foreach ($c as $v) { $all[] = $v; } }
[] 追加比 array_push 快。 $a[] = $v 是专门优化的字节码指令;array_push($a, $v) 是一次函数调用。一次 push 多个值时 array_push($a, $x, $y) 才划算。
大集合用 Generator。 几百万行的数据不需要一次进内存:
function readLines(string $file): Generator
{
    $fh = fopen($file, 'r');
    try {
        while (($line = fgets($fh)) !== false) {
            yield $line;
        }
    } finally {
        fclose($fh);
    }
}定长且元素类型固定时,SplFixedArray 省 10% 内存(16 字节 vs 18 字节左右),代价是不能用字符串键,也不能 [] 追加。
isset 比 array_key_exists 快。 前者只查哈希槽,后者还要判断值是否为 null。只有「键存在但值为 null」需要区分时才用后者。
array_shift 是 O(n)。 它要把所有元素前移并重排索引,队列场景用 SplQueue 或者双指针读索引:
$i = 0;
while ($i < count($queue)) {
    $item = $queue[$i++];   // O(1)
}
七、小结
- PHP 数组是有序哈希表,不是连续内存;顺序由插入链维护
- 每个值 16 字节的 zval,哈希形态额外要 32 字节的 Bucket
- 连续整数键会走 packed array,内存省到 1/4(18 MB vs 70 MB)
- 赋值走写时复制,不修改就零成本;一改才分离
unset不缩容,要回收就整变量销毁或$a = []- 循环里别
array_merge,$a[] =比array_push快,大数据用 Generator
理解了这三层结构,「为什么这里内存爆了」「为什么这个 foreach 慢」这类问题就不用猜了。