下面两个函数,教科书都会标成「空间复杂度 O(1)」:
function sumRecursive(array $a, int $i = 0): int {
    if ($i >= count($a)) return 0;
    return $a[$i] + sumRecursive($a, $i + 1);
}

function sumLoop(array $a): int {
    $s = 0;
    foreach ($a as $v) $s += $v;
    return $s;
}
它们都只用了一个 $s 和一个下标,都不随规模增长开辟新容器。按定义,额外空间都是常数。
但实测下来,第一个在 10 万元素时要 29.6 MB,第二个要 0 字节。
空间复杂度的定义没错,它数的是「随规模增长的额外空间」,只是把常数因子、容器开销和运行时栈都当成了 0。这篇就把这几个被当成 0 的东西挨个量出来。
所有数字在 PHP 8.3.36(Linux)上用 memory_get_usage() 实测,脚本在文末。
一、先量一个「元素」
谈空间之前,得先知道一个元素值多少字节。PHP 里这个数不是固定的,因为它取决于你把它放在哪。
| 对象 | 实际占用 |
|---|---|
| 整数、浮点、布尔、null | 0 字节 |
| 字符串 10 字节 | 48 字节 |
| 字符串 100 字节 | 160 字节 |
| 字符串 1000 字节 | 1280 字节 |
空 stdClass | 40 字节 |
| 匿名类,1 个属性 | 56 字节 |
闭包(无 use) | 384 字节 |
闭包(use 1 个变量) | 760 字节 |
标量是 0 字节,因为 memory_get_usage() 只统计 Zend 分配器从堆上要的内存。整数 42 直接塞在变量的 zval 里(16 字节),那块内存在编译期就跟着函数栈分配好了,不走堆,所以不计入。
字符串是超线性膨胀的。 10 字节的内容占 48 字节,100 字节占 160,1000 字节占 1280。多出来的部分是 zend_string 头(24 字节:引用计数 + 哈希缓存 + 长度)加上 Zend 分配器按固定 bin 补齐的开销。所以别按「内容长度」估内存,要按「长度 + 24,再往上取到分配器的档位」。
创建闭包是有成本的。 一个不捕获任何东西的闭包 384 字节,use 一个变量就涨到 760。在循环里造 10 万个闭包(比如给数组每个元素套一层回调),光闭包对象就是 76 MB。
顺手一个坑:字面量数组根本不分配
| 写法 | 占用 |
|---|---|
$a = [1, 2, 3, 4, 5]; | 0 字节 |
$a = []; for (...) $a[] = $i; | 216 字节 |
再对字面量 $a[] = 6 | 216 字节 |
PHP 7 之后,字面量数组编译成不可变常量数组,放在编译产物里共享,赋值只是让变量指向它。只有你第一次往里写,才因为写时复制而真的分配一份 —— 上面第三行那 216 字节就是这次复制。
这意味着:$a = [1,2,3] 在 1000 个函数里各写一遍,内存里只有一份。写时复制那一篇讲过数组的 COW,这里补的是它连初始分配都省了。
二、递归:栈就是 O(n)
回到开头那个 sumRecursive。把递归深度拉起来,量它到底吃多少:
| 递归深度 | 栈空间 | 每层 |
|---|---|---|
| 100 | 0.0 MB | 40 字节 |
| 1,000 | 0.3 MB | 302 字节 |
| 10,000 | 2.9 MB | 302 字节 |
| 50,000 | 14.7 MB | 307 字节 |
| 100,000 | 29.6 MB | 310 字节 |
每层递归约 300 字节,这是 PHP 8 的调用帧成本:函数信息、返回地址、局部变量的 zval 槽、以及一些 VM 状态。深度上来之后这个常数完全主导内存。
同样 10 万次迭代的 for 循环,栈空间是 0 字节 —— 循环体反复复用一个帧。
那个「100 层只占 40 字节/层」是假象:层数太少时,固定开销(函数入口本身)摊不薄,302 才是稳定值。
所以:
- 递归的额外空间 = O(1) 这个说法,只在「不把栈算进去」的口径下成立
- 真正的空间复杂度是 O(深度),跟每层 300 字节相乘
- 深度 10 万、20 万在 PHP 里不会栈溢出(没有固定栈上限),但会先把
memory_limit撞了 —— 表现得像「内存泄漏」,其实是栈
判断标准很简单:递归深度可能上千,就该改成迭代或显式栈。业务里典型的坑是「递归遍历树/分类」,一棵深 5000 的树就是 1.5 MB,看着不多,但如果每个请求都跑一遍,pm.max_children 乘上去就是几百 MB。
三、生成器:321 MB 变 1.2 KB,还更快
「别把大结果集装进数组」是老生常谈,但很少有人量过差距有多大。
造 100 万行字符串,两种消费方式:
$produce = function (int $n) {
    for ($i = 0; $i < $n; $i++) {
        yield sprintf('line %d: some payload here', $i);
    }
};

// A:全部收进数组
$arr = iterator_to_array($produce(1000000), false);

// B:逐个消费
foreach ($produce(1000000) as $line) {
    $len += strlen($line);
}| 写法 | 耗时 | 峰值内存 |
|---|---|---|
iterator_to_array | 339.0 ms | 321.2 MB |
foreach 生成器 | 105.4 ms | 约 1.2 KB |
内存差 27 万倍,这个不意外。意外的是生成器还快 3 倍 —— 因为省掉了 100 万次 zval 分配、字符串引用计数维护和哈希表扩容。省内存和快,在这里不冲突。
生成器对象本身不是免费的:未开始时 512 字节,取到第一个值后 832 字节。所以「用生成器」的常数成本是 0.5 KB 级别,跟数组的 O(n) 完全不是一个量级。
一个细节:iterator_to_array 那 321 MB 摊到 100 万条上,每条占 300 字节左右 —— 而每行的内容其实只有 30 字节。剩下的全是结构开销:一个 zval、一个 Bucket、一个 zend_string 头。同样的内容如果先 implode 成一个大字符串,只要 30 MB 出头,差一个数量级。这也是为什么读日志不要用 file()(上一篇量过:81 MB 文本读成数组要 215 MB)。
生成器还有个好性质:break 提前退出后内存增量是 0,不留残留。所以「取前 N 条」的场景用它最合适。
四、数组扩容:多一个元素,内存翻倍
packed 数组的容量按 2 的幂增长。在 2 的幂处采样内存,能看到明显的台阶:
| 元素数 | 占用 | 每元素 |
|---|---|---|
| 1 | 216 字节 | 216 字节 |
| 8 | 216 字节 | 27.0 字节 |
| 1,024 | 0.02 MB | 20.1 字节 |
| 65,536 | 1.00 MB | 16.1 字节 |
| 1,048,576 | 16.00 MB | 16.0 字节 |
| 1,048,577 | 32.00 MB | 32.0 字节 |
最后两行是关键:只多 1 个元素,内存从 16 MB 跳到 32 MB。 因为 1048576 = 2²⁰,容量正好用满;再加一个就要翻倍到 2²¹,多出来的 1048575 个槽全是空的。
这就是「稳态 16 MB 的程序为什么在 32 MB 的 limit 下 OOM」—— 它可能只是多处理了一条数据。
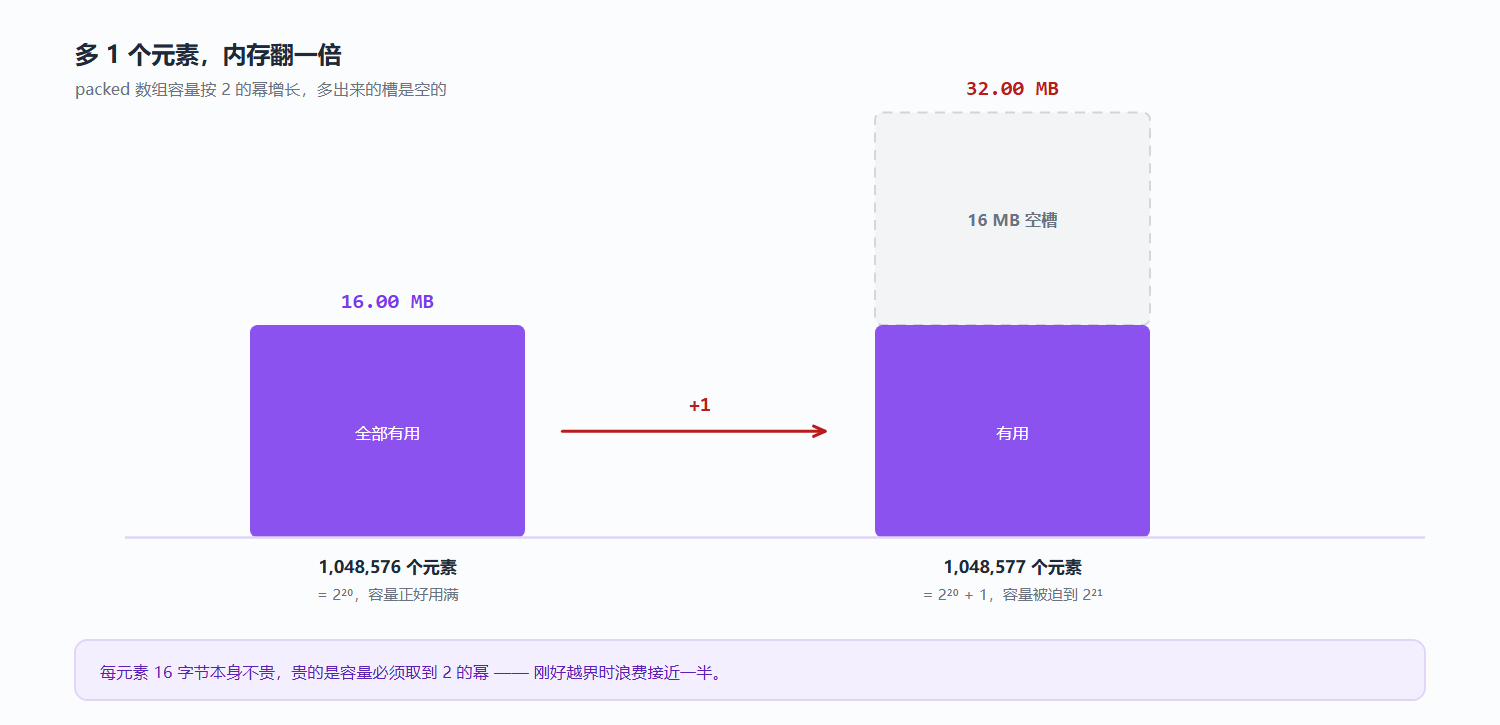
早期每元素 216 字节并不是元素贵,是数组头贵:HashTable 结构加初始桶区大约 200 字节,摊在 1 个元素上就显得离谱。元素数上去后收敛到 16 字节,正是 zval 的大小。
顺带纠正一个预期:扩容不会产生双份峰值。实测「峰值 / 稳态 = 1.00」,因为 perealloc 尽量原地扩,Zend MM 也不保留旧块。所以「预分配能省内存」是不成立的 —— array_fill 和逐个 append 的峰值都是 16.00 MB。预分配省的是扩容时反复复制的时间,不是空间。
真正省空间的办法只有一个:别用数组。
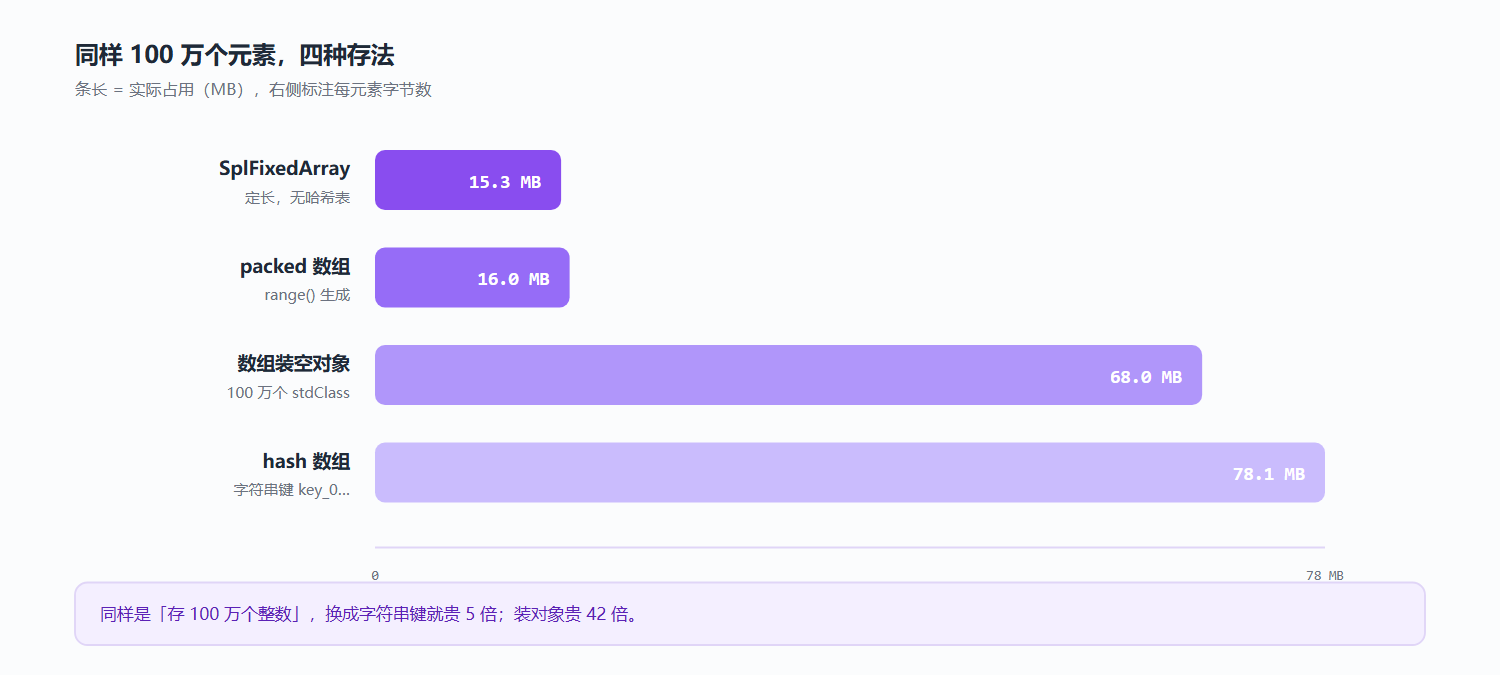
$f = new SplFixedArray(1000000); // 15.3 MB,每元素 16.0 字节,完全线性SplFixedArray 没有哈希表、没有 2 倍容量,长度固定,内存严格等于 n × 16。代价是不能 [] 追加,必须一开始就知道长度。
三个容器的每元素成本对比:
| 容器 | 100 万元素 | 每元素 |
|---|---|---|
SplFixedArray | 15.3 MB | 16.0 字节 |
packed 数组(range) | 16.0 MB | 16.8 字节 |
| hash 数组(字符串键) | 78.1 MB | 81.9 字节 |
| 数组装空对象 | 68 MB | 680 字节 |
字符串键的 hash 数组每元素 82 字节 —— 一个 zval(16)+ 一个 Bucket(32)+ 一个 zend_string 键(约 32),再加哈希表的空槽。同样是「100 万个东西」,用整数键和字符串键差 5 倍。
五、字符串拼接:. 和 .= 差 625 倍
流传最广的一条是「$s .= $x 是 O(n²),要用数组攒再 implode」。实测下来这句话得改。
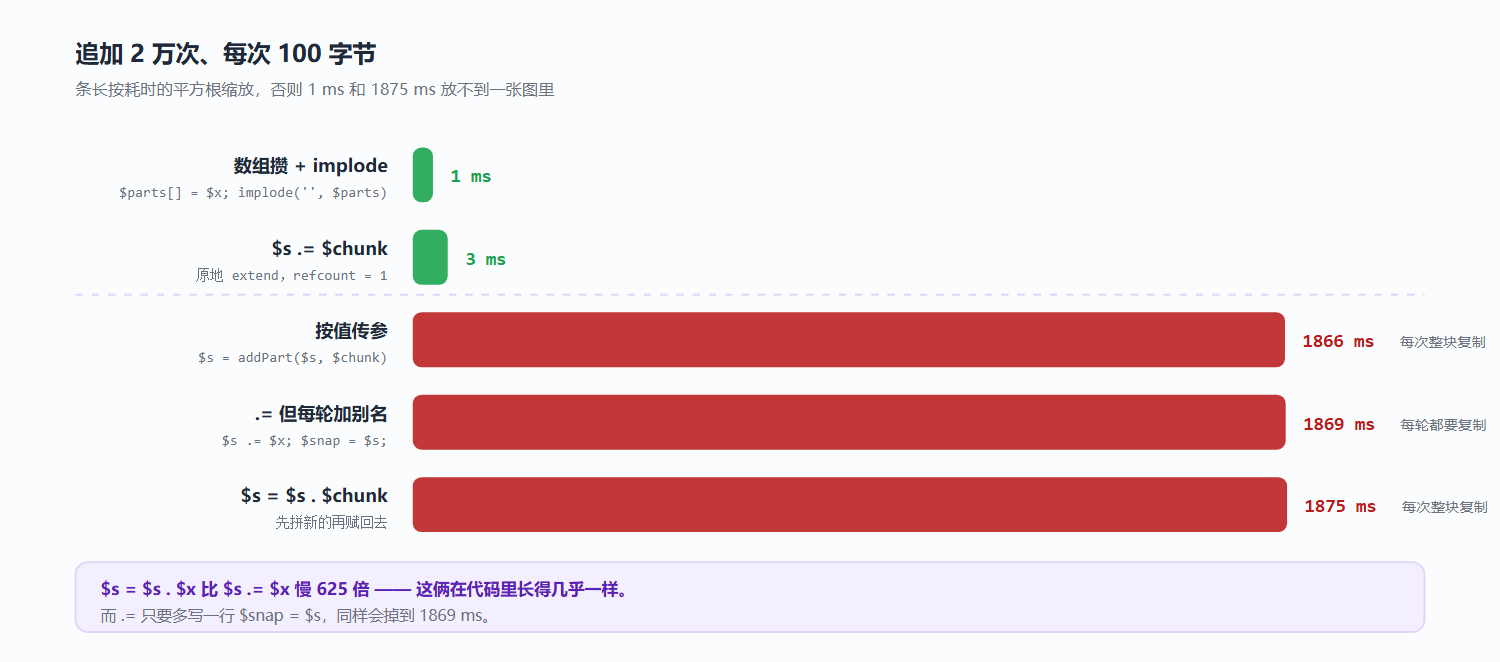
同样追加 2 万次、每次 100 字节(最终约 1.9 MB):
| 写法 | 耗时 | 峰值内存 |
|---|---|---|
$s .= $chunk | 3 ms | 2.29 MB |
$s = $s . $chunk | 1875 ms | 4.20 MB |
按值传参 $s = addPart($s, $chunk) | 1866 ms | 4.20 MB |
数组攒 + implode | 1 ms | 3.11 MB |
$s .= $chunk,但每轮 $snap = $s | 1869 ms | 4.20 MB |
三个结论:
1. .= 本身是摊销 O(1) 的。 3 ms 干完 2 万次,内存 1:1 线性增长(每追加 1 MB 就占 1 MB,没有锯齿)。因为 refcount = 1 时 Zend 用 zend_string_extend 原地扩,不是每次新建。
2. $s = $s . $chunk 和 $s .= $chunk 不是一回事。 前者要先把两个串拼成一个新的,再赋回去,每次都整块复制 —— 慢 625 倍。这两个写法在代码 review 时几乎看不出区别,但性能差了三个数量级。
3. .= 一旦有别名,就退化成 O(n²)。 最后一行每轮 $snap = $s 制造一次引用,下次 .= 发现 refcount > 1,必须先复制一份再追加。于是每轮都复制,1869 ms。
这条最阴:$snap = $s 可能是为了打日志、可能是为了出错时回滚,看着无害,但它把整个循环推进了 O(n²)。
所以正确的说法是:
.=在没有其他变量引用这块字符串时是摊销 O(1);一旦每轮都产生别名,就是 O(n²)。$s = $s . $x无论何时都是 O(n²)。
implode 攒数组最快(1 ms),但内存最高(3.11 MB)—— 数组本身要占一份,最后拼出来的字符串再占一份。时间和空间在这里是反的,别默认「数组攒更省」。
六、怎么写才算「算清」
空间复杂度真正的公式不是 O(1) / O(n),而是:
峰值内存 ≈ Σ(元素数 × 单元素字节) + 容器头 + 栈深度 × 300 字节 + 分配器取整损耗四项里只有第一项是教科书教的,后三项全是常数被当成 0。
量的时候有几个必须知道的细节:
memory_get_usage(true) 和 (false) 差很多。 true 返回的是向系统申请的内存页,粒度 2 MB —— 测小对象永远是 0 或 2 MB,没法用。false 是 Zend 分配器的精确字节数,这篇所有数据都是它。
memory_get_peak_usage() 是进程级的,要用 memory_reset_peak_usage() 复位。 PHP 8.2 才有这个函数。不复位的话,前面测试的峰值会一直压着后面。
每个用例必须独立进程。 Zend 把释放的内存还进自己的空闲链表,不还给操作系统,所以同一个进程里连着测,后一个用例的 baseline 已经继承了前一个的高度。第一版我在一个进程里测五种读法,量出「SplFileObject 占 232 MB」,独立进程一测是 2 MB。
别用数组去记录你正在测的东西。 我第一版用 $jumps[] = [...] 记录扩容点,结果记录数组自己随扩容增长,形成正反馈,把 32 MB 量成了 390 MB。要记录就预先分配 SplFixedArray,且只存 int。
七、小结
- 空间复杂度的定义没错,但它把常数因子、容器头、栈、分配器取整都当成了 0,这四项在 PHP 里能差出一个数量级
- 一个元素不是 1 字节:packed 数组 16~17 字节,字符串键 hash 数组 82 字节,装对象 680 字节
- 字面量数组是编译期常量,0 字节;第一次写入才因 COW 分配
- 递归的栈是 O(深度),每层约 300 字节;10 万层 29.6 MB,同样的迭代是 0 字节
- 生成器把 321 MB 变成 1.2 KB,还快 3 倍;对象本身 512~832 字节
- 数组容量按 2 的幂,1048576 到 1048577 会让内存翻倍;扩容不留双份峰值,预分配省时间不省空间
.=是摊销 O(1),$s = $s . $x是 O(n²),差 625 倍;.=一旦每轮产生别名,也会退化成 O(n²)- 想真正压住内存只有三条路:流式处理(生成器/
fgets)、定长容器(SplFixedArray)、别把中间结果攒成数组
排查内存问题时的顺序:
- 先看峰值还是稳态 ——
memory_get_peak_usage()比memory_get_usage()更能暴露扩容和临时分配 - 算最大那个容器 —— 元素数 × 单元素字节,字符串键的按 82 算,别按 16
- 找循环里的
$arr[] =—— 能不能改成生成器或者直接处理 - 找递归 —— 深度乘 300 字节,超过 10 MB 就该改迭代
- 找每轮都在复制的字符串 ——
$s = $s . $x、按值传参、循环里的别名
实测环境:PHP 8.3.36 (cli) / Linux / 3.7 GB 内存。全部用 memory_get_usage(false),每个用例独立进程。脚本在 tools/mem_bench/,php types.php、recursion.php、grow.php、gen.php、concat.php 分别对应上面五组数据。
没有评论